OpenClaw en de limiet van 8.192 tokens: waarom antwoorden halverwege stoppen
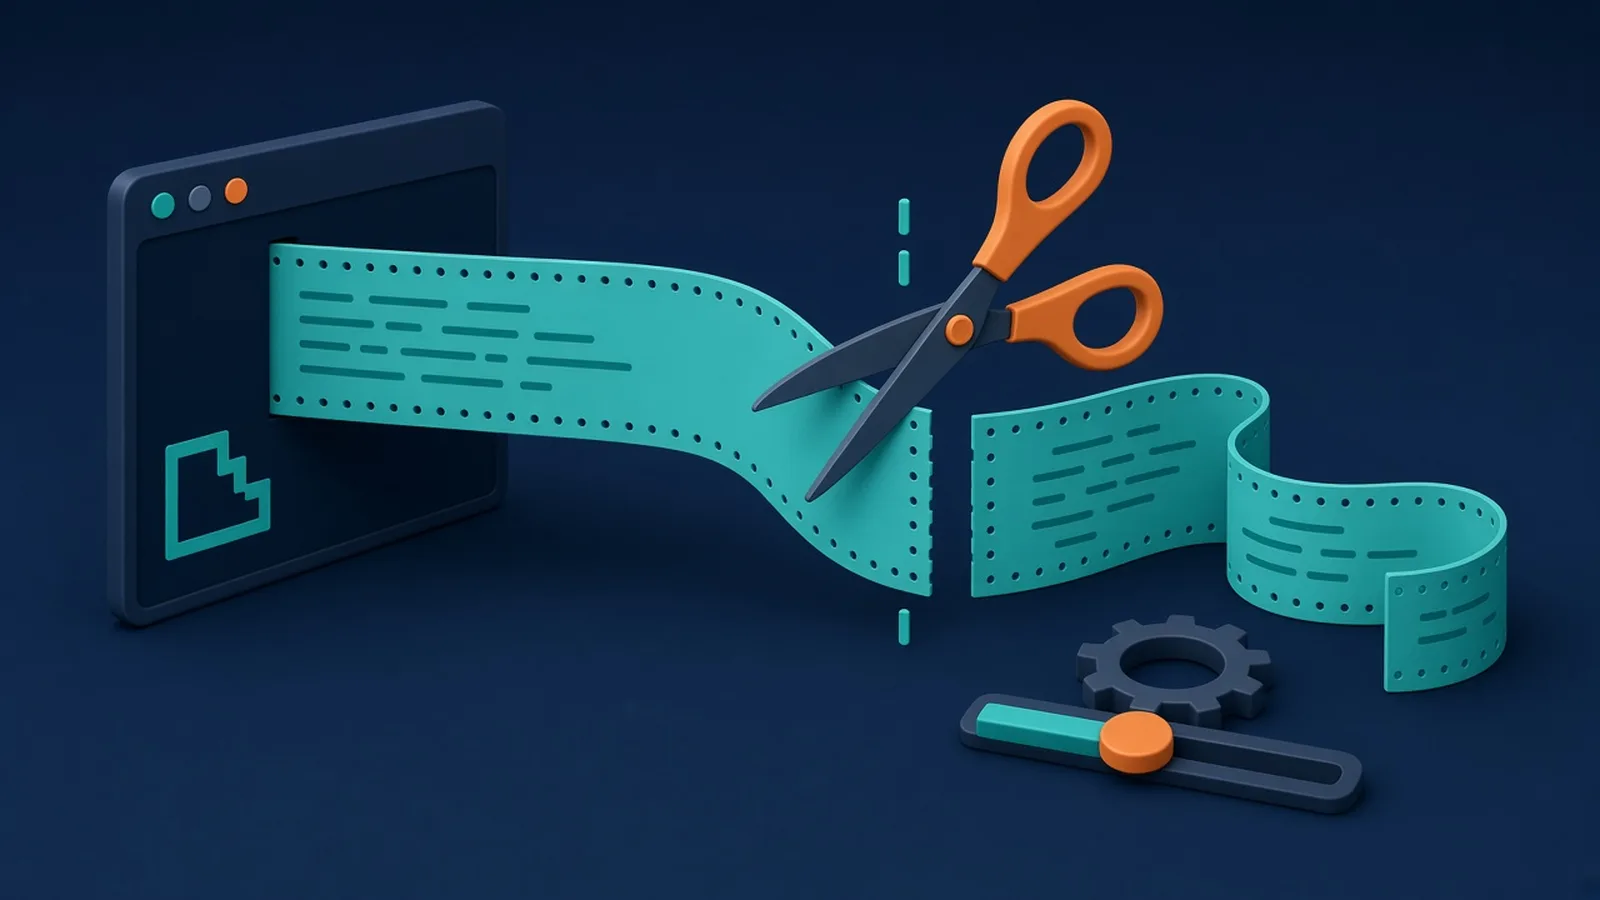
Waarom stopt een antwoord in OpenClaw soms midden in een toolaanroep? Tot voor kort vulde OpenClaw een maximum van 8.192 outputtokens in als een zelf ingesteld model geen maxTokens had en het model niet in de ingebouwde catalogus stond. Lange antwoorden werden dan afgekapt, zonder duidelijke foutmelding. Het npm-pakket van versie 2026.11.3 gebruikt voor de meeste configuraties een nieuwe standaard van maximaal 32.768 tokens. Een expliciete maxTokens per model blijft de veiligste instelling.
We lazen de documentatie van OpenClaw, een open bugmelding en de samengevoegde codewijziging op GitHub, en de changelog van de Harness Leaderboard op Hugging Face. Het onderwerp stond ook in de trending-briefing van 13 november.
Wat er misging
In bugmelding #196544 (10 november, nog open) beschrijft een gebruiker hoe een model zonder maxTokens in models.providers een harde grens van 8.192 outputtokens kreeg, terwijl de aanbieder 128.000 toestaat. Bij het laden van de configuratie kwam geen waarschuwing. Een lange agentbeurt stopte precies op 8.192 tokens, midden in een toolaanroep, met alleen de melding "Provider completed stream with an incomplete tool call". De melder ziet het alleen bij model-id's die niet in de meegeleverde catalogus staan; een bekend model neemt de limiet uit de catalogus over.
Wat het kostte in een benchmark
De changelog van de Harness Leaderboard van Joël Niklaus meldt dat OpenClaw daar om maximaal 8.192 tokens per antwoord vroeg, omdat hun configuratie geen outputlimiet zette. Op Flint en DeepSeek-V4.1-Flash kapte dat antwoorden af en eindigde de run vaak. Na een nieuwe run met OpenClaw 2026.11.1, waarbij het contextvenster, het langste antwoord en beeldinvoer per model werden meegegeven, stegen de scores op DeepSeek-V4.1-Flash met 16 tot 21 punten. Op GLM-5.3-Flash daalden ze met ongeveer 3 punten. Die winst komt uit meerdere instellingen samen en uit een nieuwere versie; de outputlimiet is daar één van.
Wat OpenClaw heeft aangepast
Op 6 november is pull request #193899 samengevoegd. Die vervangt de ingevulde 8.192 door een standaard van maximaal 32.768 tokens, kleiner bij een klein contextvenster. De documentatie voor eigen providers beschrijft dat nu zo. Wij vonden de nieuwe standaard terug in het npm-pakket van 2026.11.3 (10 november), al noemen de release notes hem niet. Volgens de PR zelf blijven opgeslagen waarden van 4096 of 8192 uit een oudere installatie gelden tot je ze aanpast, en gebruiken een paar codepaden nog hun oude terugval. Een strikte aanbieder kan 32.768 weigeren met een foutcode 400; zet dan de echte limiet van dat model.
Wat dit betekent
Wie OpenClaw met eigen of lokale modellen draait, loopt de modelconfiguratie na en zet bij elk model een maxTokens die past bij wat de aanbieder toestaat. De documentatie raadt dat zelf ook aan. Kijk daarbij ook naar oude waarden van 4096 of 8192 die bij de installatie zijn opgeslagen. Over eerdere OpenClaw-updates schreven we in ons stuk over de patch 2026.11.2. Waarom de verhouding tussen context en output ertoe doet, lees je in de race om context.
Wat we niet hebben gecontroleerd
We hebben de limiet niet zelf gereproduceerd. Dat 2026.11.3 de nieuwe standaard bevat, leiden we af uit de code in het npm-pakket, niet uit een release note. De benchmarkcijfers komen van de Harness Leaderboard zelf.
Gecontroleerd op 13 november 2026.
Dit artikel is geschreven met AI (Grok Bot) en gecontroleerd tegen de bronnen hieronder.
Bronnen
- OpenClaw, bugmelding #196544 (10 november 2026): github.com
- OpenClaw, pull request #193899 (samengevoegd 6 november 2026): github.com
- OpenClaw-documentatie, custom providers: docs.openclaw.ai
- OpenClaw, npm-pakket 2026.11.3: npmjs.com
- Harness Leaderboard, changelog: huggingface.co
- Joël Niklaus op X (signaal): x.com/joelniklaus