Cloudflare Browser Run: /snapshot levert nu ook PDF, links en JSON
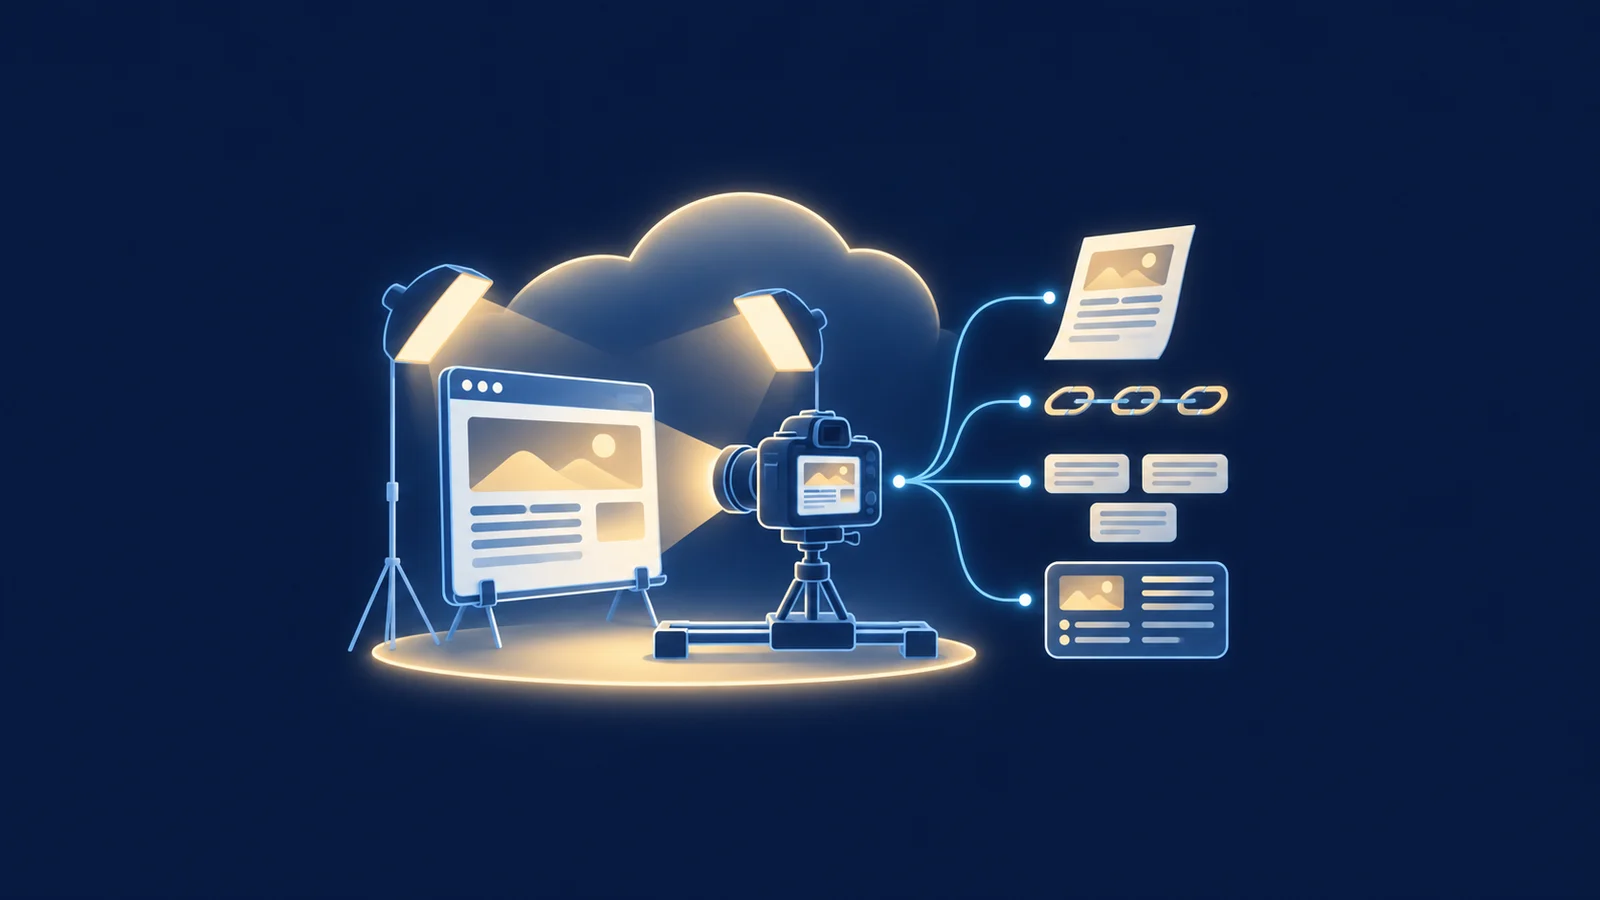
Wat is er nieuw aan /snapshot in Cloudflare Browser Run? Sinds 19 november geeft het endpoint uit één keer laden van een pagina ook een PDF, de links op de pagina, losse elementen en met AI geëxtraheerde JSON terug. Eerder leverde /snapshot alleen HTML, schermafbeeldingen, Markdown en de toegankelijkheidsboom. Wie meer nodig had, moest dezelfde pagina een tweede keer laten openen.
We lazen de changelog van Cloudflare van 19 november. Het nieuws ging rond via een post van @CloudflareDev op X en stond in de trending-briefing van 21 november.
Wat er gebeurde
Browser Run is de dienst van Cloudflare die een echte browser in de cloud laat draaien, vaak voor agents die webpagina's moeten lezen. Het endpoint /snapshot haalt in één verzoek meerdere formaten van dezelfde pagina op. Daar komen vier formaten bij: pdf, links, scrape en json. Elk formaat gebruikt dezelfde opties als het losse endpoint met die naam.
| Nieuw formaat | Wat het teruggeeft | Let op |
|---|---|---|
pdf | de pagina als PDF, met dezelfde pdfOptions als /pdf | wordt als laatste gemaakt |
links | de links op de pagina, ook alleen zichtbare of alleen interne | opties als bij /links |
scrape | elementen die passen bij opgegeven selectors | elements is verplicht |
json | gestructureerde gegevens, door Workers AI uit de HTML gehaald | vraagt prompt of response_format; kost Workers AI-gebruik |
Details
De formaten worden in een vaste volgorde vastgelegd, niet in de volgorde van het verzoek. De PDF komt als laatste, omdat printinstellingen de pagina kunnen veranderen. Een live pagina kan tussen twee opnames veranderen. Mislukt één formaat, dan mislukt het hele verzoek. Bij JSON geldt één tijdslimiet voor alles samen, standaard 60 en hoogstens 120 seconden, inclusief navigatie, herhaalpogingen en de AI-aanroep. Een snapshot vraagt minstens twee verschillende formaten; voor één formaat blijft het losse endpoint bedoeld.
Wat dit betekent
Voor ontwikkelaars die agents laten browsen scheelt dit verzoeken en tijd. Een agent die een pagina wil archiveren, de links wil volgen en een paar velden wil uitlezen, deed dat eerder in twee of drie aparte rondes. Nu kan het in één. Omdat alle formaten van dezelfde geladen pagina komen, passen ze ook beter bij elkaar, met het voorbehoud dat een live pagina tussendoor kan veranderen.
Het JSON-formaat is handig maar niet gratis: het draait op Workers AI en telt mee in dat verbruik. En wie veel pagina's ophaalt, raakt ook aan de vraag hoe uitgevers met zulke verzoeken omgaan. Eerder schreven we over AI-assistenten in de browser, over de open-source browser Kitesurf en over een lek in de KV-cache van Workers AI. Over het spanningsveld met uitgevers gaat ons stuk over robots.txt.
Wat we niet hebben gecontroleerd
We hebben de nieuwe formaten niet zelf aangeroepen en geen prijzen nagerekend. Wat een JSON-snapshot kost, hangt af van het Workers AI-model en staat niet in de changelog.
Gecontroleerd op 21 november 2026.
Dit artikel is geschreven met AI (Claude) en gecontroleerd tegen de bronnen hieronder.
Bronnen
- Cloudflare, Capture PDFs, links, scraped elements, and extracted JSON with /snapshot (19 november 2026): developers.cloudflare.com
- @CloudflareDev op X over Browser Run /snapshot: x.com